Airtableで重複レコードを削除する方法──名寄せの実務と、Dedupe拡張が使えない場面
移行直後の顧客テーブルに同じ会社が3件並んでいる——Airtableで重複を削除する方法は、Dedupe拡張・フォーミュラでの検知・スクリプトの3つです。ただしDedupe拡張もScripting拡張も公式ドキュメント上は「All paid plans」で、Freeプランでは両方とも使えません。この記事では公式仕様(マッチング方式3種・50件/回の上限)の裏取りと、実案件で遭遇した表記ゆれ7パターン、そして完全自動化で失敗した実録から、どこまでを機械に任せるべきかの線引きを解説します。
移行直後の顧客テーブルに「株式会社クロミネ製作所」「クロミネ製作所」「(株)クロミネ製作所」が並んでいる。同じ会社なのに、3件のレコードとして存在している。この状態でダッシュボードを作ると、取引社数が水増しされます。 Airtableで重複を削除する方法は3つあります。Dedupe拡張、フォーミュラでの検知、スクリプト。どれを採用するかは重複の種類と契約しているプランによって決まります。 そして、最初に知っておくべき事実があります。Dedupe拡張もScripting拡張も、公式ドキュメント上は「All paid plans」(有料プラン限定)です。Freeプランでは、重複を削除する専用の道具が両方とも使えません。 この記事では、実際のExcel・スプレッドシート移行案件で遭遇した表記ゆれのパターンと、プラン別に取れる手段、そして「完全自動化しようとして失敗した」実録を書きます。
この記事でわかること
- Airtableで重複を削除する3つの方法と、それぞれを利用できるプラン
- Dedupe拡張の3つのマッチング方式(完全一致/類似/あいまい)が実際に吸収する差異
- Freeプランで重複を検知する方法(フォーミュラ)
- 移行時に重複が生まれる最大の原因=リンクフィールドの「幽霊レコード」
- 実務で遭遇した表記ゆれ7パターンと、どこまで自動化すべきかの判断基準
- 名寄せを1回限りで終わらせず、再発を防ぐための設計
そもそも、なぜ重複が生まれるのか
重複は「入力ミス」で生まれると思われがちですが、実務で見る重複の大半は構造的な原因で生まれています。
| 発生源 | 何が起きるか | 典型的な症状 |
|---|---|---|
| Excel・スプレッドシートからの移行 | 元データが複数ファイルに分かれていて、同じ取引先が各ファイルに存在 | 同名レコードが2〜5件 |
| リンクフィールドへの文字列貼り付け | Airtableは同名レコードがなければ新規作成する | 表記ゆれの数だけレコードが増える |
| フォームからの流入 | 送信者が会社名を自由記述する | 「(株)」「株式会社」「カブシキガイシャ」が混在 |
| 複数人での手入力 | 誰が入れたかで表記が変わる | スペースの有無、全角半角 |
| 外部システムからの自動連携 | 連携側のキーとAirtable側のキーが一致しない | 実行のたびに増える |
ここで特に厄介なのが2番目です。移行時に最も大量の重複を生み出す原因となるため、章を分けて詳しく後述します。
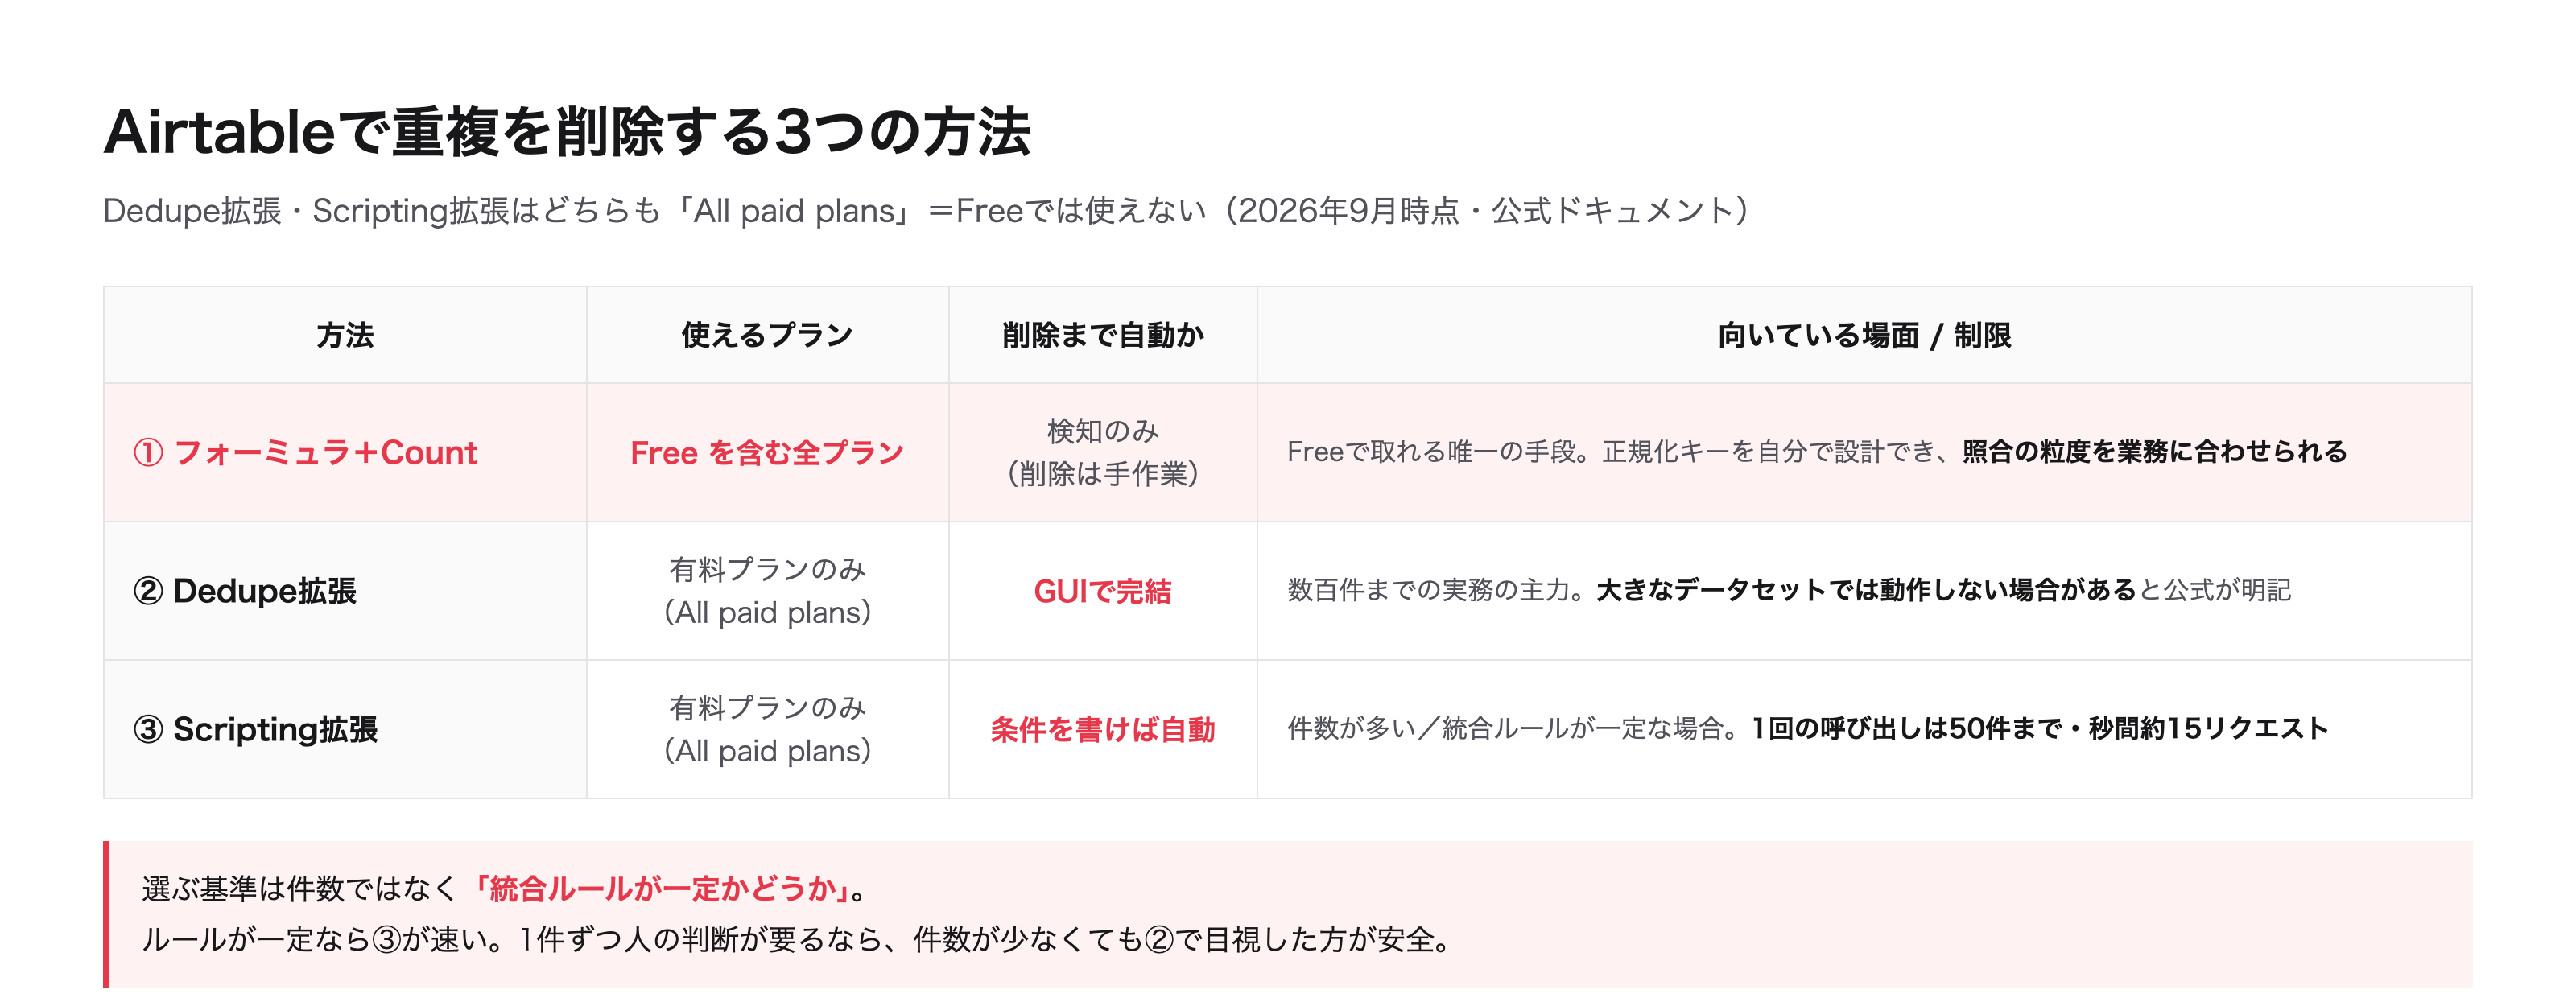
方法1:Dedupe拡張(有料プラン・GUIで完結)
Airtable公式の重複検出拡張です。テーブルを指定し、比較するフィールドを選ぶと、重複候補をグループにして表示してくれます。 プラン:公式ドキュメントには「All paid plans」と記載されており、Freeプランでは利用できません。
「3つのマッチング方式は、何を吸収するのか」
Dedupe拡張におけるテキストフィールドの比較方式は3種類あり、公式ドキュメントには具体例とともに定義されています。実務で使うのは基本的にSimilar(類似)です。「句読点・空白・語順の違いを吸収する」という定義は、日本語の表記ゆれの一部(全角半角スペース、中点の有無)にそのまま効きます。
| 方式 | 公式の定義 | 公式の例 |
|---|---|---|
| Exact(完全一致) | 「Has the same, case-sensitive value」=大文字小文字を区別して同一の値 | "J. K. Meowling" と "J. K. Meowling" |
| Similar(類似) | 「Has the same value, but may have different capitalization, punctuation, accents, whitespace, or ordering of words」=大文字小文字・句読点・アクセント・空白・語順の違いを吸収 | "J. K. Meowling" と "j k meôwling" |
| Fuzzy(あいまい) | 「Looks for typos and transposition errors」=タイプミスと文字の入れ替わりを探す | "J. K. Meowling" と "J. K. Lemonwig" |
Fuzzyは公式自身が警告している
「fuzzy matching can often result in false positive matches, since its search is so broad」(検索対象が広すぎるため、誤検出が頻繁に発生する可能性がある)。上の公式例のとおり、"Meowling" と "Lemonwig" が同一と判定されてしまいます。これを顧客マスタに適用すると、まったく別の会社同士が勝手に統合されます。
「マージで何が起きるか」
Dedupe拡張は「削除」だけでなく「マージ」もできます。重複グループの中から残す値をフィールドごとに選び、選んだ値が緑色になって統合後のレコードに入ります。 複数の値を持てるフィールド型——公式の記載では multiple select, multiple collaborator, linked records, and attachments ——は、Ctrl+クリック/Shift+クリックで複数選択して合成できます。合成時に重複する値は除かれ、ユニークな値だけが残ります。 つまり、添付ファイルやリンクは「片方を捨てる」のではなく「両方を持ち越す」ことができます。営業履歴が片方のレコードに、契約書がもう片方に付いている——という移行直後のよくある状態は、この操作で片付きます。
取り消し(undo)の手段は公式に記載がない
削除やマージを実行する前には、必ずベースのスナップショットを作成するか、CSVエクスポートによるバックアップを取得してください。
「使えない場面はありますか」
公式は限界も明記しています。「For large bases/datasets, the dedupe extension may be slow or unable to review, merge, and delete records」——大きなベース・データセットでは、動作が遅くなるか、レビュー・マージ・削除ができない場合がある。 具体的な件数の閾値は公式に書かれていません。数万件規模のテーブルを扱うなら、拡張に頼り切らず、後述のスクリプトかビューでの分割を前提に設計してください。
方法2:フォーミュラで検知する(Freeプランでも可能)
Freeプランでは拡張が使えません。それでも「重複がどこにあるか」は数式で見つけられます。考え方はシンプルです。照合用のキーを作って、そのキーが何件あるかを数える。
ステップ1:正規化キーの列を作る 表記ゆれを吸収した「比較用の文字列」をフォーミュラフィールドで作ります。
Airtable フォーミュラ
SUBSTITUTE(
  SUBSTITUTE(
    SUBSTITUTE(
      SUBSTITUTE(LOWER(TRIM({会社名})), "株式会社", ""),
    "(株)", ""),
  "(株)", ""),
" ", "")「株式会社クロミネ製作所」「(株) クロミネ製作所」「クロミネ製作所 」は、いずれも `クロミネ製作所` という同じキーになります。
ステップ2:同じキーの件数を数える Airtableには「他のレコードを横断して数える」関数がありません。ここは自己リンクを使います。
- 1正規化キーの値を管理する「名寄せキー」テーブルを別途作成する
- 2元のテーブルに、その名寄せキーテーブルへのリンクフィールドを追加する
- 3正規化キーの値をリンクフィールドにコピー&ペーストする(同一のキーがあれば自動的に紐づく)
- 4名寄せキーテーブル側に Count フィールドを作成する
このCountの値が「2以上」になっている行が、重複の発生しているキーです。 この方法の利点は、Freeプランで動くこと、そしてキーの作り方を自分で決められることです。「会社名だけ」ではなく「会社名+郵便番号」「メールアドレスのドメイン部分」など、業務に合った粒度で照合できます。ただし、削除自体は手作業になります。検知までがフォーミュラの守備範囲です。
方法3:スクリプトで処理する(有料プラン・大量向け)
件数が多い、あるいは統合ルールが複雑な場合はScripting拡張を使います。 プラン:Dedupe拡張と同様に、公式ドキュメント上は「All paid plans」と記載されています。
スクリプトを作成する前に、公式ドキュメントに明記されている2つの制限を把握しておく必要があります。これらを考慮せずに実装すると、処理の途中で停止する原因になります。
| 制限 | 公式の記載 |
|---|---|
| 1回の呼び出しで50件まで | 「You may only update up to 50 records in one call to `updateRecordsAsync`」(create/deleteも同じく50件) |
| 秒間15リクエスト程度 | 「The scripting extension enforces a rate limit of approximately 15 requests per second」 |
たとえば1,000件の重複レコードを削除する場合、50件ずつに分割して20回呼び出す設計にする必要があります。
javascript
const table = base.getTable("取引先");
const query = await table.selectRecordsAsync({
  fields: ["会社名", "登録日"]
});

// 正規化:法人格表記・空白・大文字小文字を落とす
const normalize = (s) =>
  (s || "")
    .replace(/株式会社|有限会社|\(株\)|(株)/g, "")
    .replace(/[\s ]/g, "")
    .toLowerCase();

// キーごとにレコードをまとめる
const groups = new Map();
for (const record of query.records) {
  const key = normalize(record.getCellValueAsString("会社名"));
  if (!key) continue;
  if (!groups.has(key)) groups.set(key, []);
  groups.get(key).push(record);
}

// 各グループで最古の1件を残し、残りを削除対象にする
const toDelete = [];
for (const [key, records] of groups) {
  if (records.length < 2) continue;
  records.sort((a, b) =>
    new Date(a.getCellValue("登録日")) - new Date(b.getCellValue("登録日"))
  );
  toDelete.push(...records.slice(1));
}

output.text(`削除対象:${toDelete.length}件`);

// 50件ずつ削除する(公式の上限)
while (toDelete.length > 0) {
  await table.deleteRecordsAsync(toDelete.splice(0, 50));
}削除の前に、必ず件数を目視する
コード内で `output.text()` を使って件数を先に出力しているのは、実際の削除処理へ進む前に確認するためです。正規化のルールを1文字誤っただけで、本来10件であるはずの削除対象が900件に膨らむことがあります。実務では、いきなり `deleteRecordsAsync` を書かず、まず「削除対象フラグ」のチェックボックスを立てるだけのスクリプトを走らせ、グリッドで中身を確認してから削除する方が安全です。
移行で重複が生まれる最大の原因:リンクフィールドの「幽霊レコード」
ここが、移行案件で最も事故が起きる場所です。 Airtableのリンクフィールドに文字列を貼り付けると、同名のレコードがあればそこに紐づき、なければ新しいレコードを作ります。これは便利な挙動ですが、移行時には牙をむきます。
たとえば、案件テーブルの「取引先」リンクフィールドに、Excelからコピーした取引先名の文字列を一括貼り付けしたとします。このとき移行元のExcelに表記ゆれが5パターン存在していれば、取引先マスタ側には意図しない5件の独立したレコードが自動生成されます。しかもユーザーが明示的に作ったものではないので、気づきにくい。 数百件の案件を貼り付けた後で取引先マスタを見ると、身に覚えのないレコードが並んでいる——これが「幽霊レコード」です。
「どう防げばよいですか」
対処は、削除ではなく手順です。 1. 先にマスタ側を名寄せする(取引先テーブルを正規化・重複削除してから) 2. 貼り付ける文字列も、マスタの表記に揃えてから貼る(元のExcel側で置換しておく) 3. 少量で試す:20〜50行だけ貼り、マスタに新規レコードが増えていないか確認する 4. 増えていたら、貼り付けた文字列とマスタの表記が一致していない 3番目を飛ばして1万行を貼ってから気づくと、どのレコードが幽霊でどれが本物かの切り分けに、貼り付け作業の何倍もの時間がかかります。
実務で遭遇する表記ゆれ7パターン
移行案件で実際に出てきたパターンです。上から順に、自動化していい度合いが下がります。
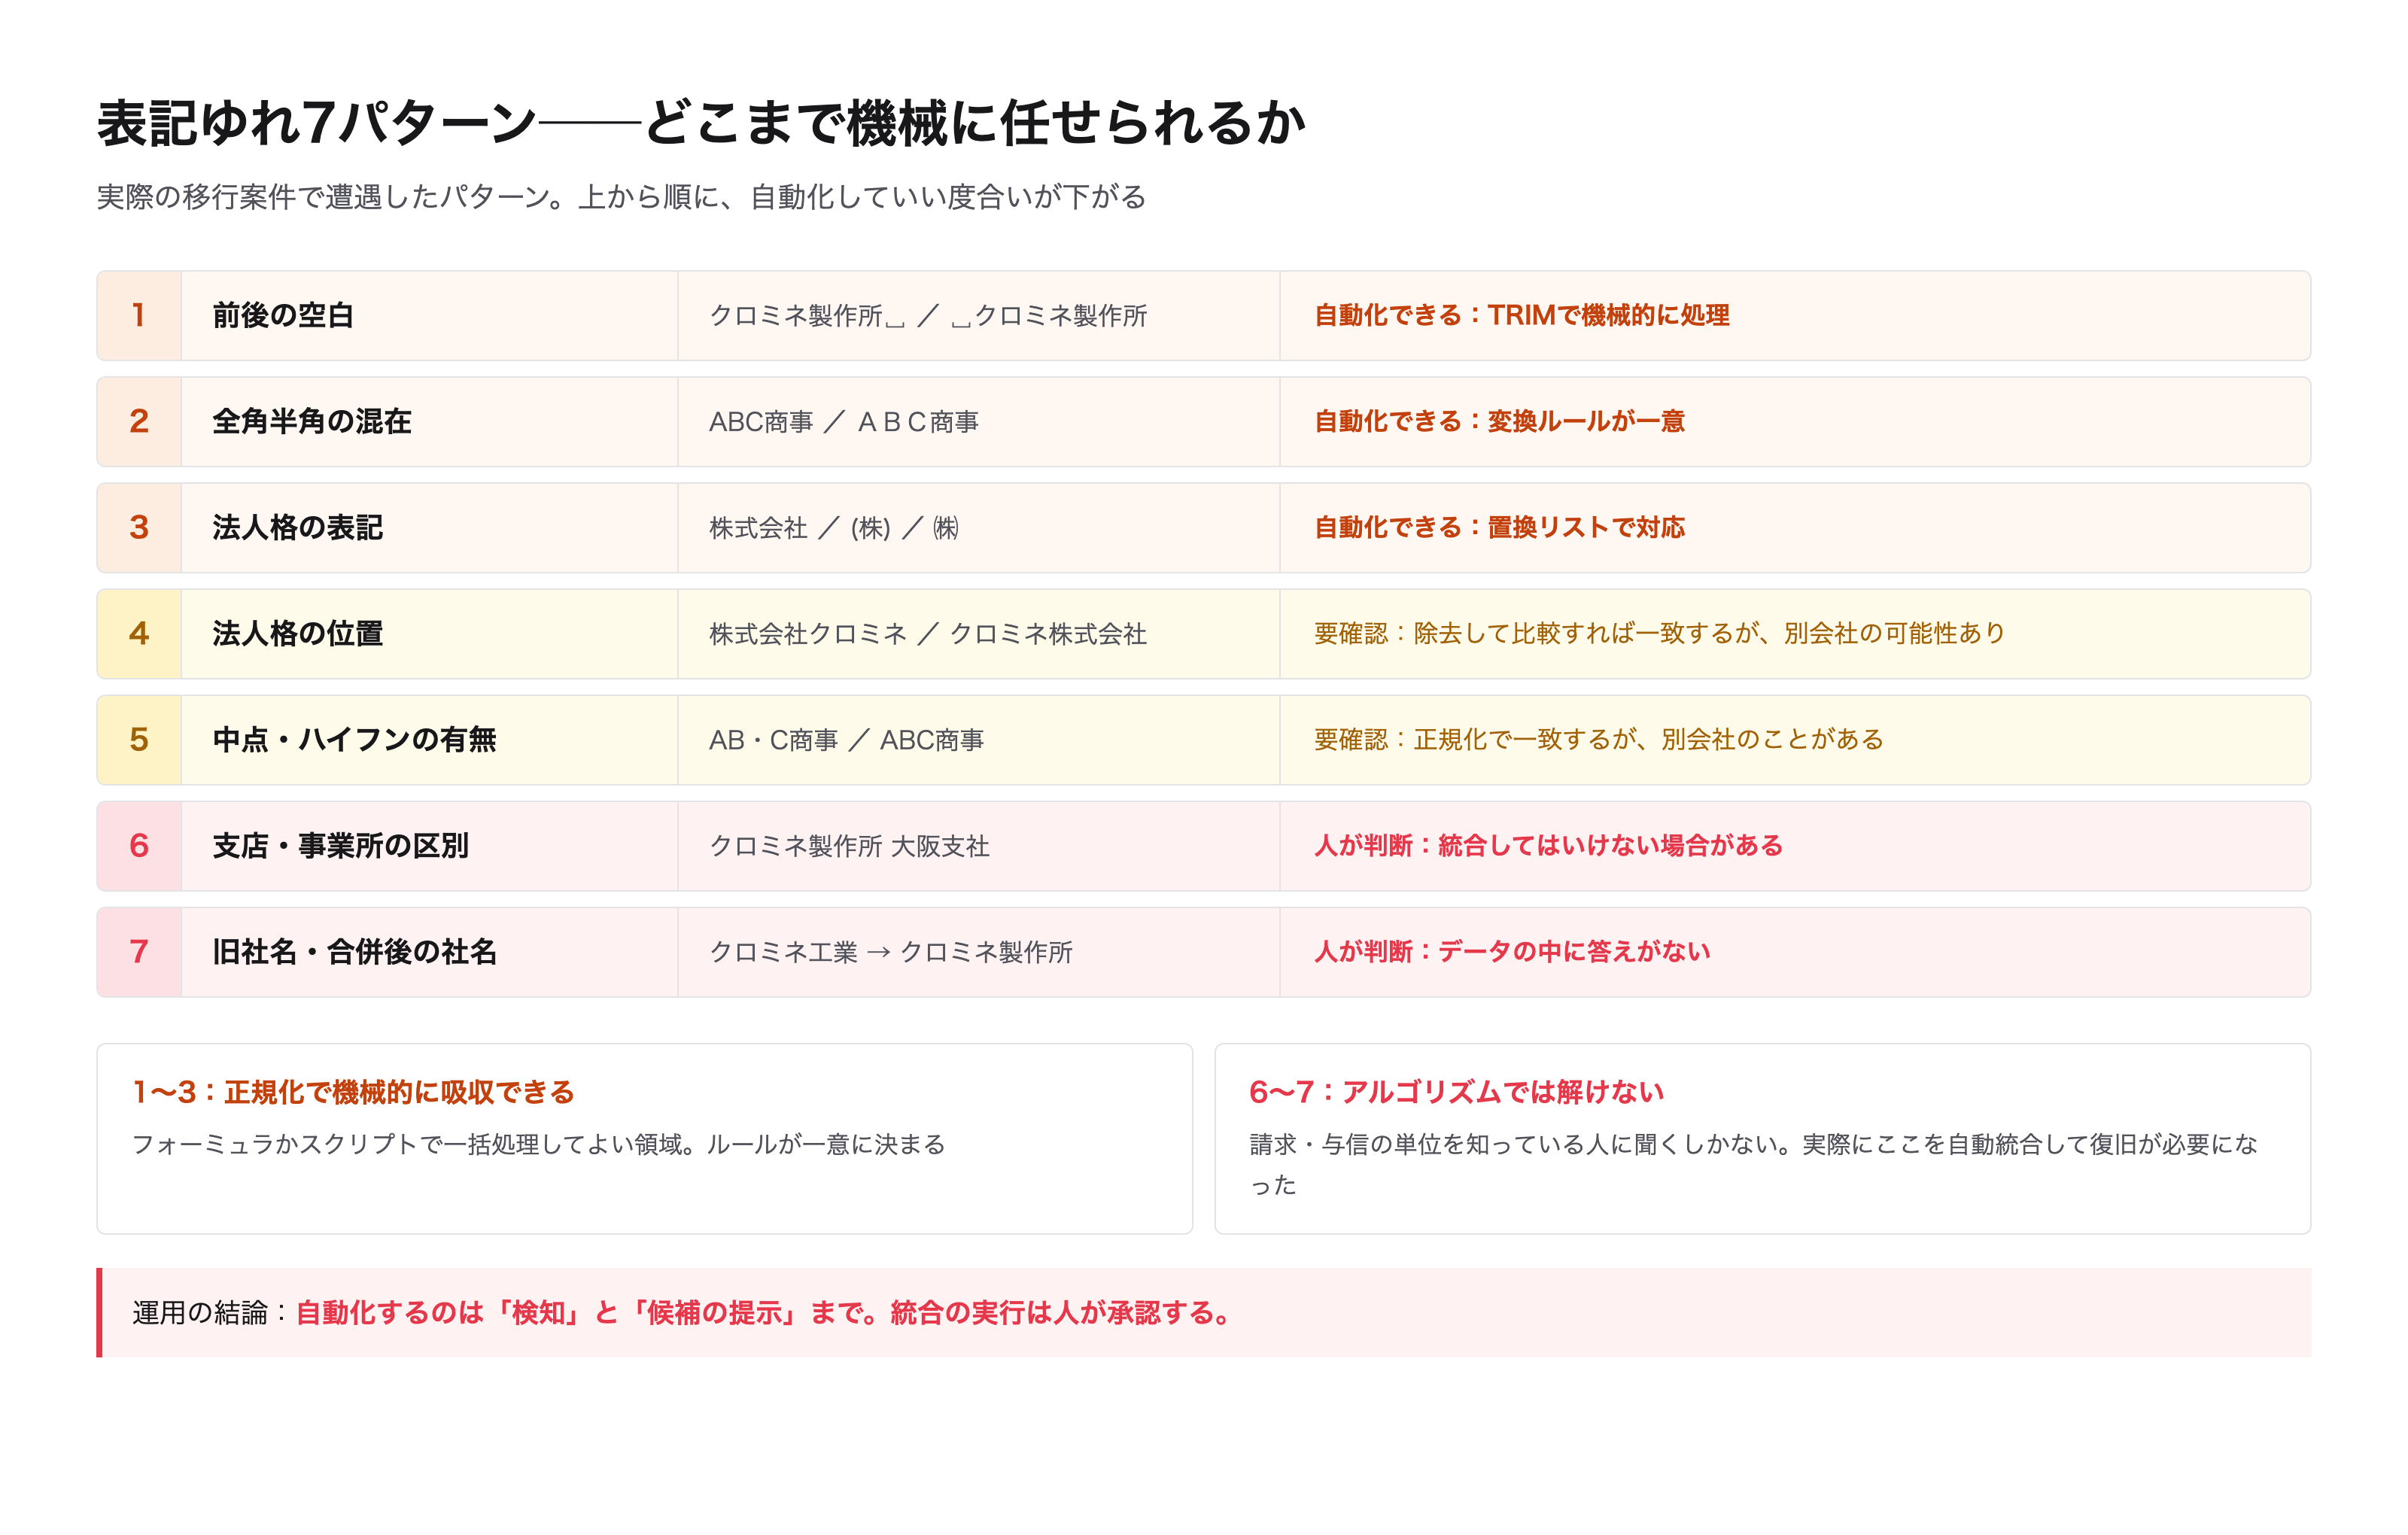
| # | パターン | 例 | 自動化の可否 |
|---|---|---|---|
| 1 | 前後の空白 | `クロミネ製作所 ` | ✅ TRIMで機械的に処理できる |
| 2 | 全角半角の混在 | `ABC商事` / `ABC商事` | ✅ 変換ルールが一意 |
| 3 | 法人格の表記 | `株式会社` / `(株)` / `㈱` | ✅ 置換リストで対応可能 |
| 4 | 法人格の位置 | `株式会社クロミネ` / `クロミネ株式会社` | ⚠️ 除去して比較すれば一致する。ただし除去後も別会社の可能性あり |
| 5 | 中点・ハイフンの有無 | `AB・C商事` / `ABC商事` | ⚠️ 正規化で一致するが、別会社のことがある |
| 6 | 支店・事業所の区別 | `クロミネ製作所 大阪支社` | ❌ 統合してはいけない場合がある。取引単位が支店ごとなら別レコードが正しい |
| 7 | 旧社名・合併後の社名 | `クロミネ工業` → `クロミネ製作所` | ❌ 人の知識が要る。データだけでは判断できない |
「完全自動化で失敗した話」
ある移行案件で、上の1〜5を全部フォーミュラで正規化し、一致したものを機械的に統合するスクリプトを書きました。処理は成功し、数百件あった重複が綺麗に消えました。 問題は翌週に出ました。支店ごとに担当営業も与信枠も違う取引先が、1レコードに統合されていたのです。パターン6です。データの見た目は「同じ会社」でも、業務上は別管理が正しかった。戻すのに、統合前のスナップショットからの復旧が必要になりました。 そこから運用を変えました。自動化するのは「検知」と「候補の提示」まで。統合の実行は人が承認する。 具体的には、スクリプトで「統合候補」のビューを作り、担当者がチェックを入れたものだけを次のスクリプトで統合する2段階にしています。 パターン6と7は、どれだけ賢いアルゴリズムを書いても、データの中に答えがありません。誰が管理しているかを知っている人に聞くしかない。
名寄せを1回で終わらせないために
重複を消しても、入口を塞がなければ1か月後に同じ状態に戻ります。再発を止める設計です。
- 1入口を単一選択・リンクフィールドにする:自由記述の会社名フィールドをやめ、既存マスタから選ぶ形にする
- 2フォームに自由記述の社名を置かない:必要なら「未名寄せ」ビューで受け、担当者がマスタへ紐づけてから本番テーブルへ移す
- 3正規化キー列を常設する:フォーミュラフィールドとして常に持てば、重複はビューのフィルタで即座に見つかる
- 4月1回、重複チェックのビューを見る:Countが2以上のビューを保存し、定例の運用チェックに入れる
- 5外部連携は必ずキーで照合する:会社名ではなく、取引先コードや法人番号などの一意キーで突き合わせる
最後の項目が一番効きます。名寄せが必要になるのは、そもそも一意キーがないからです。 法人番号(国税庁が公表している13桁の番号)を最初から持たせておけば、表記ゆれは照合の問題ではなくなります。
よくある質問
「Freeプランで重複を削除する方法はありませんか。」
専用の道具はありません(Dedupe拡張もScripting拡張も有料プラン)。フォーミュラ+Countで検知し、手作業で削除する形になります。件数が多いなら、有料プランに上げて拡張を使う方が結果的に安くつきます。
「Dedupe拡張のFuzzyマッチングは使えますか。」
公式自身が「誤検出が頻繁に起きうる」と明記しています。顧客マスタなど、統合ミスの代償が大きいデータには使わないでください。Similarで足りることがほとんどです。
「削除したレコードは戻せますか。」
Dedupe拡張の公式ドキュメントに取り消しの手段は記載されていません。作業前にスナップショットかCSVエクスポートを取ってください。
「何件くらいからスクリプトにすべきですか。」
件数よりも「統合ルールが一定かどうか」で決めてください。ルールが一定なら数千件でもスクリプトが速い。ルールが個別判断になるなら、件数が少なくてもDedupe拡張で1件ずつ見た方が安全です。
「統合するとき、どちらのレコードを残すべきですか。」
「古い方」が基本です。リンクや履歴が多く付いているのは古いレコードだからです。ただしDedupe拡張のマージを使えば、添付やリンクは両方持ち越せます。
「支店を別レコードにすべきか、1社にまとめるべきか。」
請求と与信の単位で決めてください。 支店ごとに請求書を出すなら別レコード。本社一括なら1レコードにして支店は別テーブルにする。データの見た目ではなく、業務の単位が答えです。
まとめ
Airtableの重複削除は、道具の使い方よりどこまでを機械に任せるかの線引きが本題です。
- 1Dedupe拡張(有料プラン):GUIで完結。Similarマッチングが実用的。Fuzzyは誤検出の警告あり。大きなデータセットでは動かない場合がある
- 2フォーミュラ+Count:Freeプランでも重複を「検知」できる。削除は手作業
- 3Scripting拡張(有料プラン):50件ずつ・秒間15リクエストの制限内で書く。削除前に必ず件数を出す
- 4移行時の幽霊レコードは、削除ではなく手順(マスタを先に名寄せしてから貼る)で防ぐ
- 5支店・旧社名は自動判定できない。検知は自動、統合の実行は人の承認
データを移す前段の設計については GoogleスプレッドシートからAirtableへ移行する手順 と ExcelからAirtableへ移行するときの分解の方法論 に書いています。名寄せは移行の後に発生する問題に見えて、実際には移行前のクレンジングで大半が決まります。
同じ取り組みを、貴社でも。
「うちのデータは名寄せできる状態か」「どこまで自動化できるのか」——現状のテーブルを見せていただければ、自動化できる範囲と人の判断が要る範囲をその場でお伝えします。無料の壁打ち(30分)でご相談ください!!
AI×CRM構築サービスを見る他の記事