AIで作った業務ツールは、半年後に誰が直すのか──保守を前提にした内製の設計
AIで社内ツールが作れる時代になりました。問題は作れるかどうかではなく、壊れたときに直せるかどうかです。本番稼働中のAIエージェントを実際に保守している立場から、実案件で起きた障害の中身・確率的にズレるAI特有の壊れ方・コストが静かに膨らむ仕組み・そして保守契約で決めておくべき5項目を書きます。
AIを使えば、非エンジニアでも動くツールが作れます。ここまでは、もう当たり前になりました。本当の分かれ目は、作った3ヶ月後・半年後に来ます。動かなくなったとき、直せる人が社内にいるかどうかです。
私たちはAirtable・GAS(Google Apps Script)・生成AIのAPIを組み合わせたAIエージェントを複数の実案件で本番稼働させ、自分たちで保守しています。この記事は、その現場で実際に起きた障害と、それを踏まえて契約書に書いている保守の線引きをそのまま書きます。
この記事でわかること
- AIで作った業務ツールが実際に壊れる3つのパターンと、実案件で起きた障害の中身
- エラーを出さずに止まる「静かな故障」の正体と、気づくための通知設計
- 確率的にズレるAI特有の壊れ方への対処(2段階チェック・役割分担)
- 内製すべきもの/外注すべきものの線引きと、保守契約で決める5項目
「動いている」と「運用されている」は違う
作るのは一度きりですが、運用は毎日続きます。そして運用フェーズで起きることは、作っているときにはほとんど見えません。
実際の数字で言うと、ある実案件では開発フェーズの見積りが全6ステップで約250万円でした。そのうち導入完了後3ヶ月の保守運用対応費として20万円〜が、当初から契約に含まれています。つまり構築費用の1割弱を、作り終えた後の3ヶ月分としてあらかじめ別枠で確保しているということです。
ここを見積りに入れていない発注・内製計画は、ほぼ確実に後から揉めます。「作ったら終わり」という前提そのものが間違っているからです。
保守フェーズで実際にやっていること
| 作業の種類 | 具体例 | 頻度の実感 |
|---|---|---|
| 障害対応 | 動かなくなった箇所の原因調査と修正 | 月に数回 |
| 環境追随 | 外部サービスの仕様変更・モデル更新への対応 | 数ヶ月に1回、まとめて |
| 精度調整 | AIの出力が要件からズレたときのプロンプト修正 | 使い始めの数ヶ月は頻繁 |
| 追加要望 | 「この項目も出してほしい」という改修 | 継続的(保守対象外にすべき) |
| 引き継ぎ | 担当交代時の説明・ドキュメント更新 | 人が変わるたび |
重要なのは、下2つは「保守」ではないということです。ここを混ぜると、保守費用が青天井になります。後述の契約の項で詳しく書きます。
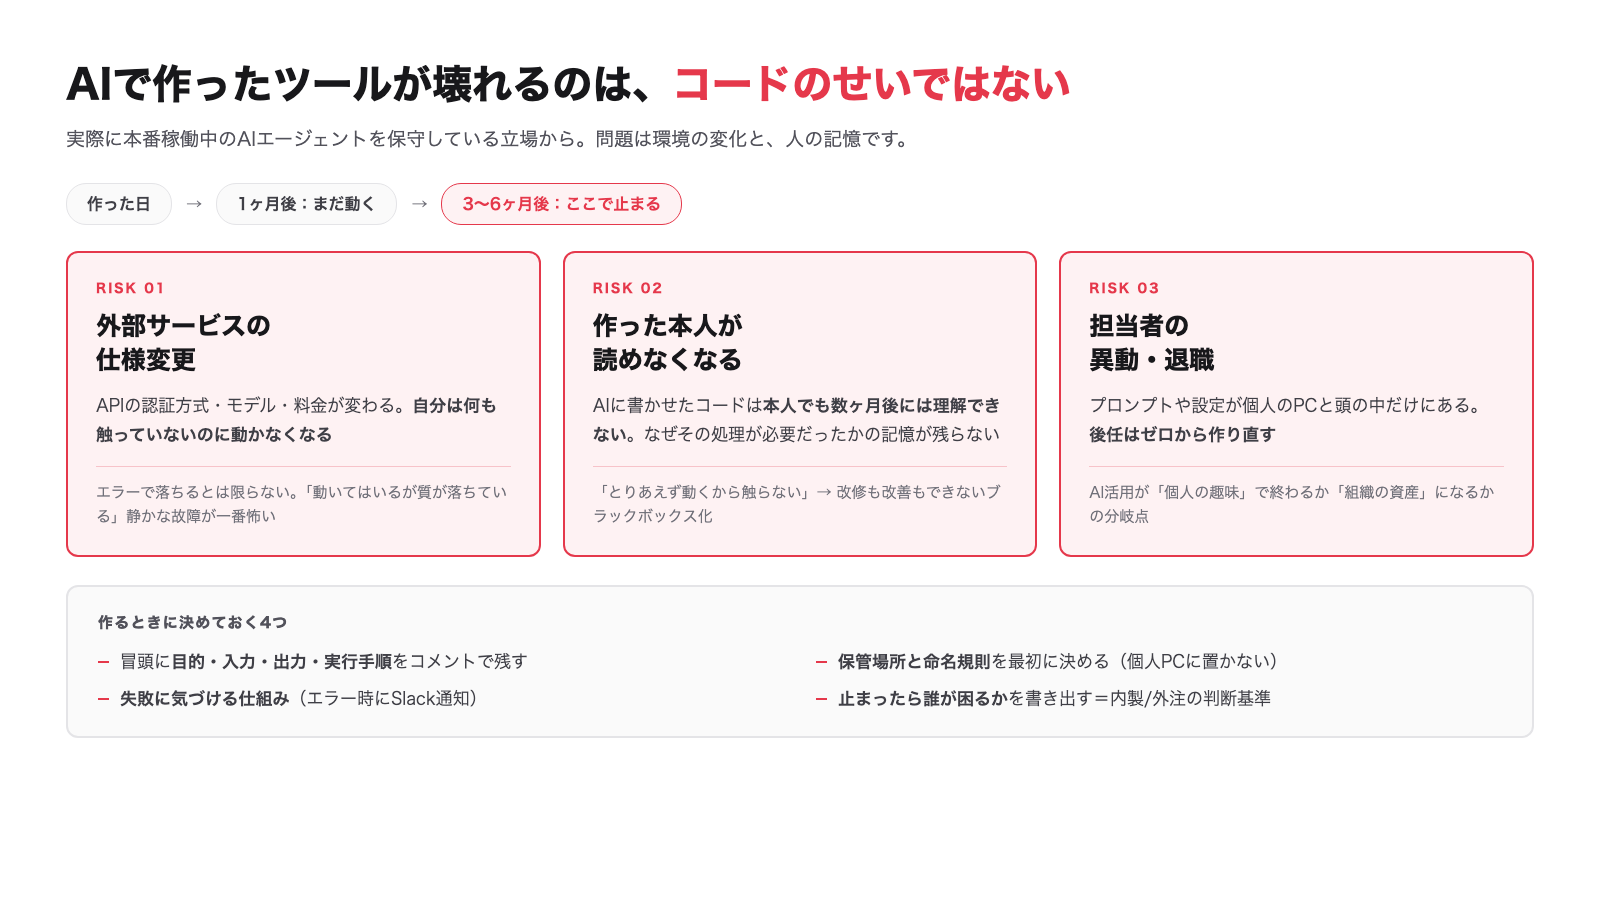
実際に壊れるのは、この3パターン
「外部サービスの仕様が変わって、静かに止まる」
APIの認証方式が変わる、モデルが更新される、料金体系が変わる——自分は何も触っていないのに動かなくなるのがこのパターンです。AI周辺は変化が速いぶん、ここが一番頻繁に起きます。
厄介なのはエラーで派手に落ちるとは限らないことです。「動いてはいるが、出力の質が落ちている」「一部のレコードだけ処理されていない」といった静かな故障は、気づくまでに時間がかかります。次の章で、実案件で起きた例を詳しく書きます。
「作った本人が、中身を読めなくなる」
AIに生成させたコードは、書かせた本人であっても数ヶ月後には解読できなくなります。これはスキルの問題ではなく、自分の手でロジックを一行ずつ組み立てていないためです。「なぜこの処理を挟む必要があったのか」という思考のプロセスが記憶に残りません。
これは決して他社事ではありません。ある案件のPoCにおいて、担当エンジニア自身が課題メモに「新しく従業員が増えた時の考慮ができている? 全コードを追えていない」と書き残しています。しかもこれは、開発を雑に進めたから起きたわけではありません。むしろAIを活用して短期間で機能を積み上げた結果、コードの総量が本人の理解の追いつく速度を超えたために起こります。AIによって開発速度が上がれば上がるほど、この理解のギャップは広がります。
「担当者が異動・退職して、誰も触れなくなる」
プロンプトや各種設定が担当者個人のPCローカル環境、あるいは本人の頭の中にしか存在しない状態です。十分な引き継ぎ資料が残されていないため、後任者は同じものをゼロから再構築せざるを得なくなります。
ここで見落とされがちなのが、アカウントおよび認証情報の管理主体です。ツールが担当者個人のアカウントに紐づいて動いていると、その社員の退職と同時に停止します。実案件でも、Botのアカウント名を変更しただけでアクセストークンが再生成され、スクリプト側の設定値を書き直すまで動かなくなった事例がありました。AI活用が「担当者個人の趣味」で終わるか「組織の資産」になるかは、ここで分かれます。
実案件で起きた「静かな故障」の正体
3パターンの中でも、最も気づきにくいのが1つ目です。実際に起きた事象をそのまま書きます。
メールをトリガーにして情報を取り込むエージェントで、「特定の送信元からのメールだけが取り込まれていない」という事象が起きました。エラーは出ていません。他のメールは正常に処理されています。一見すると動いています。
原因の切り分けに数日を費やした末、認証系のトラブルか、取得条件の不備かという2つの仮説に絞られました。最終的な原因は後者です。元の仕様が「未読メールの中から最新のものを取得し、処理完了後に既読にする」という設計になっていたため、システムが処理する前に人間がメールを開いてしまうと、永久に処理対象から除外されてしまう構造だったのです。誰も過失を犯していないのに、ツールだけが静かに止まります。
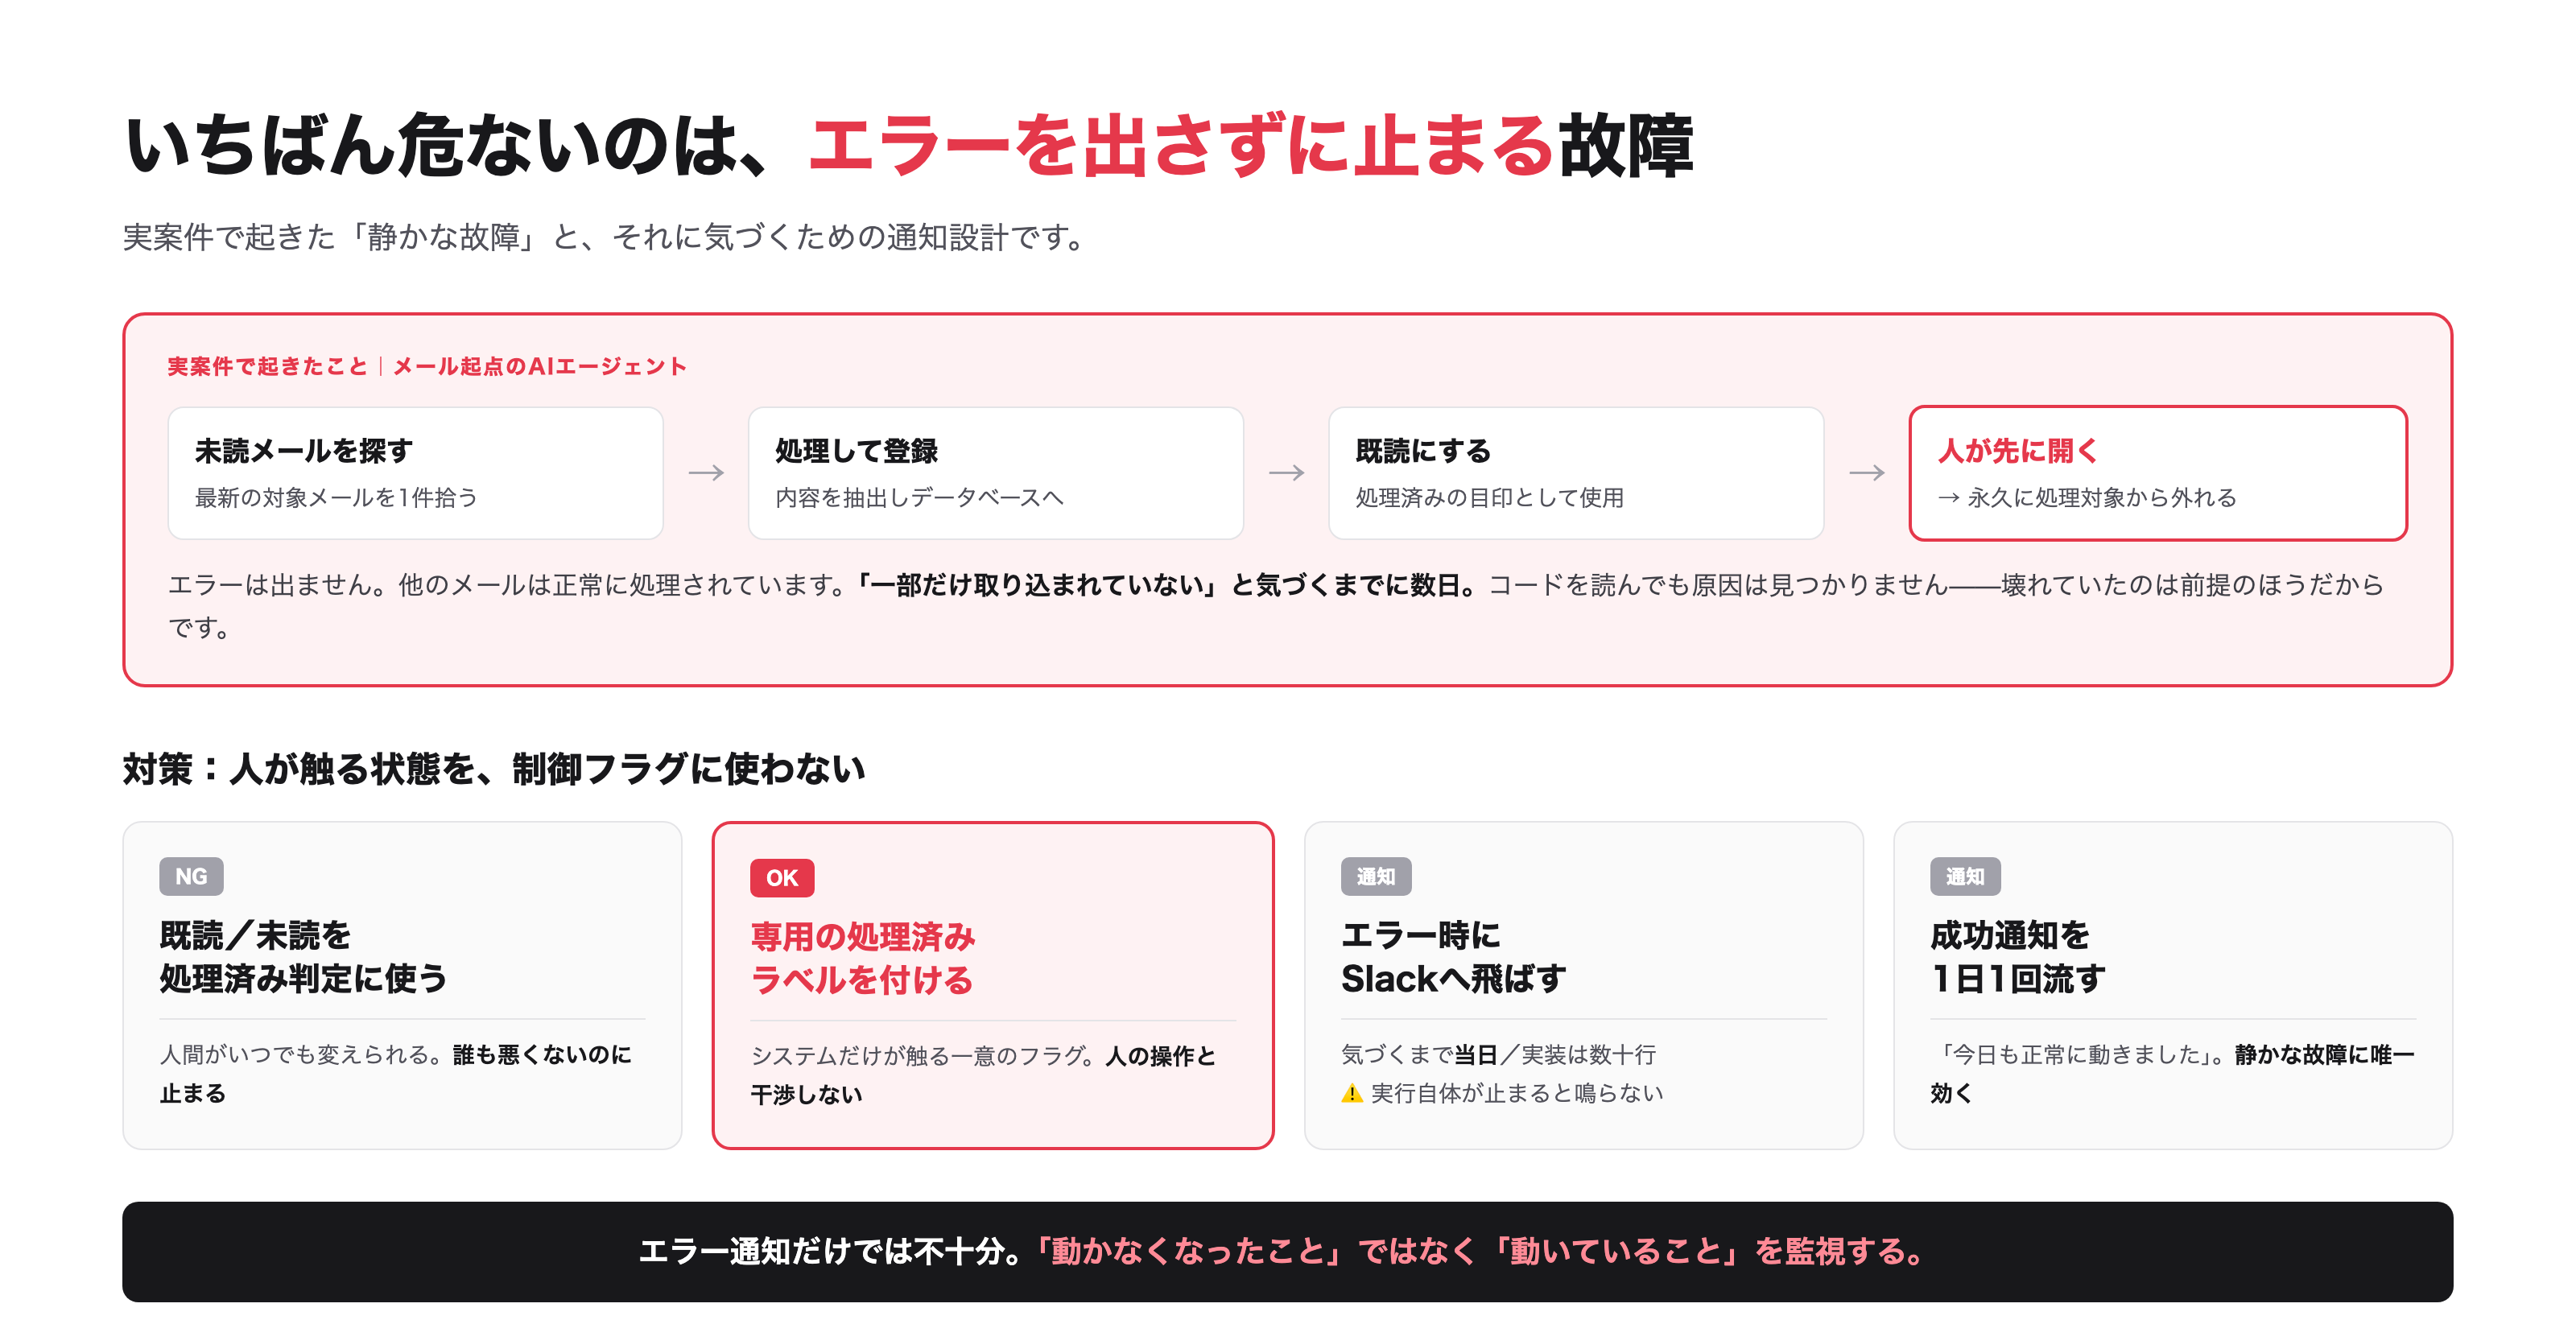
この種のトラブルは、コードをいくら眺めても見つかりません。「問題なく動く前提」と現場の運用フローにズレが生じた瞬間に発生するからです。対策として設計を見直しました。既読・未読といった人間が操作するステータスをトリガーにするのをやめ、システム専用の「処理済みラベル」を付与する方式に変更する。自前で一意の処理済みフラグを管理する方が、はるかに安全で確実です。
ここでの学び
外部サービス上のステータスを、ツールの制御フラグに流用しない。人間が触れられる場所にフラグを置けば、いつか必ず操作されます。そしてその操作は、悪意でも過失でもなく、ごく普通の業務動作として起こります。
「壊れたと気づく」までの時間を短くする
通知の仕組みと、異常に気づくまでの時間
| 通知の仕組み | 気づくまで | 実装の手間 |
|---|---|---|
| 何もしない(現場からの報告待ち) | 数日〜数週間 | ゼロ |
| エラー時にSlack通知 | 当日 | 小(数十行) |
| 定期実行の成功通知(ハートビート) | 当日 | 小 |
| 出力件数の異常を検知して通知 | 当日 | 中 |
意外に見落とされがちなのが、表の3番目にある「成功通知」です。エラー時のみ通知する設計にしておくと、システム自体が起動しなくなった場合に通知すら送信されず、異常に気づけません。「本日も正常に処理を完了しました」という定期通知を1日1回送信する仕組みを設ける方が、静かな障害の早期発見には有効です。
認証情報の置き場所が、一番の弱点になる
実務で最も事故になりやすいのが認証情報まわりです。理由は単純で、動かすために必要なのに、正しく扱う手順が誰にも共有されていないからです。実案件のSlackログを見返すと、APIキーやアクセストークンがチャットにそのまま貼られている場面が複数ありました。開発中のスピードを優先した結果ですが、これはチャットの検索履歴に永久に残るということでもあります。退職者もそのチャンネルを見ていたかもしれません。
認証情報について、最低限やること
- 1キーは必ずスクリプトプロパティ・環境変数・シークレット管理に置く — コードに直書きしない
- 2チャットに貼らない — どうしても渡す必要があるなら、渡した後に再発行する前提で扱う
- 3誰のアカウントで発行したキーかを台帳に書く — 個人アカウント発行のキーは、その人の退職で死にます
- 4キーを変えたら何が止まるかを一覧にしておく — ローテーションできない鍵は、実質的にローテーションしない鍵です
実案件で保守が一気に楽になった転換点もあります。それまでは自社の環境でツールを作り、動作不良の報告を受けるたびに自社側を直し、それをクライアント側の環境へ反映する流れでした。環境が2つあるので、反映漏れが起きるし、再現確認もできない。そこでクライアント側の共用アカウントを使わせてもらい、クライアントの環境に直接スクリプトを置いて、そこで動作確認と保守をする形に変えたところ、運用工数が大きく下がりました。
ただし、これは誰にでも勧められる方法ではありません
社外の人間が社内の共用アカウントを操作する形になるため、アクセス権限のスコープ設定・監査ログの取得・契約上の秘密保持をセットで講じる必要があります。セキュリティ規程の厳格な企業では採用できません。また2要素認証を厳格に義務付けている環境では、ログインのたびに認証コードの連携が必要となるため、共用アカウント運用自体が現実的でなくなります。その場合は環境が2つある前提で、本番反映手順を詳細にドキュメント化するしかありません。規程側の考え方はAirtableのセキュリティを情シス目線で解説にまとめています。
AIツール特有の壊れ方——確率的にズレる
従来のプログラムと決定的に異なるのは、同一の入力を与えても毎回同じ結果が出力されるとは限らないという点です。この不確実性が、保守の難易度を押し上げます。実案件のPoCフェーズで記録された課題メモには、次のような生の声が残されています。
PoCの課題メモ(実物)
- 確率的に5回に1回程度は、指定した要件からズレた出力になる
- 生成処理に1分程度の時間を要する
- プロンプトの修正がツールの動作に直結しない(対話型UIではなく、システム連携を挟む構成のため)
- 設定画面上の文言を変更しただけで、スクリプト側でエラーが発生することがある
とりわけ1点目は構造的な難題です。「システムが故障しているのか」それとも「たまたま確率のブレで誤出力したのか」の判別がつきません。再現性のない不具合は、根本原因の特定が極めて困難です。
「出力を2段階でチェックする」
実案件で大きな効果を上げたのは、AIの出力をそのまま採用せず、出力内容のルール違反を自動検知して再補正する2段階のバリデーション設計です。「月曜日のシフトは7:00〜16:00の範囲でなければならない」「この担当者は週2回・各4時間勤務とする」といった前提条件を明確なルールとして定義し、AIの生成結果がそれを満たしているかを機械的に判定します。
このチェック機構を導入した結果、同一のテストを3回実施していずれも要件を満たす出力を得られました。AIに一発で完璧な出力を求めず、誤りをシステム側で検知して自動修正させる。これこそが安定運用のための設計の要です。
「AIに任せる範囲と、関数で確定させる範囲を分ける」
同じ案件では、人件費の計算ロジックを当初AIに処理させていましたが、最終的にスプレッドシートの関数(セルの参照計算式)に切り出しました。理由は、データ変更に応じて動的に再計算できる点と、計算結果から確率的なブレを完全に排除できる点の2つです。
実際、「株式会社」や「合同会社」といった法人格の表記ゆれを正規表現で処理しようとして運用が破綻し、LLMによる抽出方式へ切り替えて解決した事例もあります。処理速度とコストが許容範囲内であれば、このアプローチの方が保守性に優れます。一方で、厳密さが求められる金額計算などをAIに任せるのは、保守性という観点では避けるべき判断です。
役割分担の判断基準
| 処理の性質 | 任せ方 |
|---|---|
| 答えが一意に決まる(計算・集計・転記) | 関数・コードで確定させる。AIに出させない |
| 表記のゆれを吸収する(社名の抽出、分類) | AIに任せる価値がある。正規表現より頑健なことが多い |
| 人間が最終判断する(提案・下書き) | AIに任せる。ただし人のレビューを必ず挟む |
プロンプトの精度改善そのものの進め方は、AI推進をひとりで任された人が、最初にやるべきことでも触れています。
コストも「静かに」壊れる
稼働が止まることだけが障害ではありません。想定外に利用コストが跳ね上がることも、重大な運用事故のひとつです。生成AIのAPIは基本的に従量課金制なので、処理対象のデータ量が増大すれば請求額も比例して増加します。実案件でも、検証の過程でトークン消費量を抑制するために一部のAI機能を一時停止する判断を下したことがあります。開発直後は少量のテストデータで検証するため安価に思えますが、本番環境で実データを流し始めた途端、コストの桁が変わるケースは珍しくありません。
さらにリスクが高いのが、過去のやり取りや文脈情報を蓄積し続ける設計のエージェントです。適切な制限をかけずに放置するとコンテキスト長が肥大化し、気づかないうちに請求額が跳ね上がる事態を招きます。私たちも、コスト予測が立たないことを理由にクライアントへの導入を見送った構成があります。
課金の見張り方
- 1APIの利用上限アラートを必ず設定する — プロバイダ側の予算アラートは開発初期に入れておく
- 2月次で「処理単価×実行件数」を定点観測する — 総額だけ見ていると、件数増なのか単価上昇なのか判別がつかない
- 3無限ループに陥る構成を避ける — システム自身を再帰的に呼び出す設計は、コストが発散します
- 4基盤側の実行回数上限にも注意する — リミットに達してサイレント停止するリスクに備える(参考:Airtable Automationsの実行上限と回避設計)
備え方:作るときに決めておく4つ
この4つがないツールは、半年後に負債になります
- 1冒頭に目的・入力・出力・実行手順をコメントで書く — 数ヶ月後の自分は別人です。AIに書かせるときも、この説明だけは自分の言葉で残す
- 2保管場所と命名規則を最初に決める — 個人のPCではなく、共有ドライブやリポジトリに。「どこにあるか分からない」が一番多い事故
- 3失敗したら気づける仕組みを入れる — エラー時にSlackへ通知するなど。何も出さずに停止する状態が最も危険
- 4止まったら誰が困るかを書き出す — これが後述の「内製か外注か」の判断基準になる
とりわけ4番目が重要です。社内のすべてのツールに、一律で強固な保守体制を用意する必要はありません。半日止まっても代替手段があるツールと、停止が即座に基幹業務のストップにつながるツールとでは、講じるべき対策のレベルが根本から異なります。
引き継ぎ資料は「A4で1枚」から始める
網羅的な仕様書の作成を目指すと、結果としてドキュメント作成自体が放置されます。実際の現場で機能しているのは、次の項目だけをA4用紙1枚程度にまとめたシンプルな資料です。
引き継ぎ1枚シートの項目
| 項目 | 書くこと |
|---|---|
| 目的 | 何の業務のために作ったか。1〜2行 |
| 入力と出力 | どこからデータが来て、どこへ出るか |
| 動く場所 | どのアカウント・どの環境で動いているか |
| 認証情報 | 何のキーが要るか。値ではなく、置き場所と発行者 |
| 実行タイミング | 手動か、定期か。定期なら何時か |
| 止まったときの症状 | 「Slackに通知が来ない」など、現場が気づける言葉で |
| 触ってはいけない場所 | 列名・シート名など、変えると壊れるもの |
特に最後の「触ってはいけない場所」を明記しておくと、誤操作による障害を大幅に抑止できます。実案件でも、管理画面の設定テキストを書き換えたことでスクリプトが異常終了したケースがありました。また、スプレッドシートの列名が勝手に変更されるのを防ぐため、該当セルを自動で保護する機能をわざわざ開発要件に追加したこともあります。変更されたくない設定は、注意喚起で守るよりも、仕組みで保護する方が確実です。
内製すべきもの/外注すべきもの
「止まったら誰がどれだけ困るか」で線を引く
| 止まったときの影響 | 推奨 | 理由 |
|---|---|---|
| 個人の作業が少し遅れる程度 | 内製で十分 | 壊れたら作り直せばいい。学習機会としても価値がある |
| チームの業務が半日止まる | 内製+保守体制 | 作れる人を複数にする。ドキュメントを必須にする |
| 顧客対応・請求など事業が止まる | 外部の関与を前提に | 「動けばいい」では済まない。設計レビューだけでも外部を入れる |
保守体制を作れないなら、最初から作らない
内製化は万能の解決策ではありません。社内で安定的に保守できるリソースを確保できない領域は、無理に内製しない方が安全です。私たちも要件を聞いた結果、「これは内製に向きません」とお伝えすることがあります。開発後の運用コストまで視野に入れると、結果的に内製の方が高くつくケースは確実に存在します。
保守を外注するなら、契約で決める5項目
保守業務を社外に委託する場合、金額の交渉よりも優先して合意すべき項目があります。この定義が曖昧なまま依頼すると、トラブル発生時にどこまで対応してもらえるのかが毎回議論になり、対応が遅れます。実際の保守契約で定義している主要項目を挙げます。
保守契約で決める5項目(実際の契約書の書き方)
| 決める項目 | 実際の書き方の例 |
|---|---|
| 何を「障害」と呼ぶか | 受入基準書で完了確認済みの機能が、仕様どおりに動作しない状態 |
| 報告の方法と形式 | Slackの所定フォーマット(再現手順・発生環境・影響範囲) |
| 応答の期限 | 重大障害は翌営業日以内に一次回答 |
| 保守の対象外 | 新機能追加、UI調整、利用規模の増加に伴う性能調整 |
| 保証しないもの | AI出力結果の精度、提供データの誤りに起因する不具合、仕様変更に起因する不具合 |
もっとも重要なのは最後の「保証しないもの」です。AIの出力精度は「保証」の対象に設定できません。受託者として善管注意義務に基づき最善は尽くしますが、確率によって結果が揺らぐ出力を100%保証することは構造上不可能だからです。この前提を明記しないまま進めると、「期待した通りの回答が得られない」というクレームが障害報告として寄せられ、双方にとって不毛な結果を招きます。
同様の理由で、「何が保守の対象外か」を明確にしておくことは、対象を定義すること以上に重要です。仕様変更や追加要望を通常の障害対応と混同すると、保守コストは確実に跳ね上がります。パートナー選定の段階でこれを見極める方法は、Airtable開発会社の選び方の「見積書は、金額ではなく『含まれていないもの』を見る」にまとめています。
期間も決める
保守契約を無期限で結ぶ必要はありません。実案件では導入完了後3ヶ月間と期間を定めています。この期間設定の目的は外部に依存し続ける体制を作ることではなく、その3ヶ月の間に社内で自律的に運用を回せる状態に持っていくことにあるからです。
「保守を外注に握られたくない」という動機
商談の場で、多くの企業から異口同音に寄せられる声があります。それが「ツールの保守をいつまでも外注先に依存したくない」という課題感です。これは外部ベンダーへの不信感ではなく、軽微な改修のたびに見積りと発注の手続きが発生し、継続的な費用負担から抜け出せなくなる構造への警戒です。
この問題意識は、システムの設計要件にも直接反映されます。ある案件では、将来的な複数拠点への展開を見据えて「プログラミングを不要とし、設定画面上の入力変更のみで拠点ごとの独自要件に対応できること」を品質要件として明文化しました。現場の担当者が扱える範囲を設定値として外部化しておけば、展開拠点が増えるたびに開発会社へ追加発注する必要がなくなります。
同じ案件では、ツールに関する操作質問を受け付ける社内向けチャットボットの設置案も出ました。日常的な問い合わせの一次対応を仕組みで吸収できれば、保守フェーズの人的負荷そのものが下がるからです。
だから私たちは、作ったものを社内で直せる状態にして引き渡すことを設計の前提にしています。ツールを納品して終わりではなく、保守できる人を育てるところまでが仕事だと考えているからです。実際、非エンジニアの方にAIツールの作り方・直し方を身につけてもらう研修も行っています(非エンジニア企業でClaude Code研修をやった実録)。
引き渡しのときに必ず渡すもの
- 1動いている環境そのもの — 自社環境のコピーではなく、相手の環境で動くもの
- 2認証情報の一覧 — 値ではなく、何がどこに入っているか・誰が発行したか
- 3設定画面で変えられる範囲の説明 — 触っていい場所と、触ってはいけない場所
- 4止まったときの症状と一次対応 — 誰に連絡するかも含めて
- 5触る人が複数いる状態 — 1人だけに引き渡さない
最後の項目が、実質的に一番効きます。引き渡し先が1人だけだと、その人が異動した瞬間にパターン03へ逆戻りします。
半年後のためのチェックリスト
作る前、または今動いているツールの点検にそのまま使えます
- 1冒頭に目的・入力・出力・実行手順がコメントで書かれている
- 2ファイルが個人のPCではなく共有の場所にある
- 3認証情報がコードやチャットに直書きされていない
- 4キーが誰のアカウントで発行されたかが分かる
- 5エラー時に人へ通知が飛ぶ
- 6実行されなくなった場合にも気づける(成功通知・件数監視)
- 7API費用の上限アラートが設定されている
- 8触ってはいけない場所が明記されている、または仕組みで保護されている
- 9止まったら誰が困るかが書き出されている
- 10触れる人が2人以上いる
- 11外注しているなら、障害の定義・応答期限・対象外が契約で決まっている
半分も埋まっていないなら、それは「動いているツール」であって「運用されているツール」ではありません。
まとめ
AIで作った業務ツールで問題になるのは、コードの品質より環境の変化と、人の記憶です。実案件で起きた障害も、根っこはコードのバグではありませんでした。人間が先にメールを開いてしまう、Bot名を変えたらトークンが変わる、設定画面の文言を変えたらスクリプトが落ちる——作った人と使う人のあいだにある前提のズレが、時間をかけて表面化しただけです。
だから対策も、技術ではなく設計と運用に寄ります。作る前に「止まったら誰が困るか」を決める。目的と手順を残す。失敗に気づける仕組みを入れる。人間が触る場所を制御に使わない。この4つだけでも、半年後の景色が変わります。
そして保守体制を作れない領域には手を出さない——これも立派な判断です。AIで作れる時代に残る価値は、「作れること」ではありません。作った後、現場で回り続けさせることです。
他の記事